První z letních pokusů resuscitovat tenhle blog naleznete ZDE. Jde o recenzi pro Naši řeč, která se pomalu (ale doufejme, že jistě) snaží stát opět zajímavým jazykovědným časopisem. Tedy pár slov o Rozhovorech s českými lingvisty.
Zobrazují se příspěvky se štítkemZ věd o jazyce. Zobrazit všechny příspěvky
Zobrazují se příspěvky se štítkemZ věd o jazyce. Zobrazit všechny příspěvky
pátek, července 17, 2009

neděle, března 29, 2009
Volání pro papíry o Wittgensteinovi a kachně!
Co mají společného Ludwig W. a kachna? Choval snad slavný filozof kachny nebo je měl rád se zelím a pěti? Nebo když "přepínáte" mody vidění, můžete střídavě vidět Ludwiga W. a Martina H.? Na některé z těchto otázek dá možná odpověď odborný filozofický seminář požádaný ve spolupráci katedrou filozofie FF ZČU a Filozofickým ústavem AV ČR. Na některé, doufejme, ne! :) Zvací plakát ZDE.
úterý, prosince 09, 2008
Z věd o jazyce XXIV: O vztahu filozofie a jazykovědy
K folklóru každé disciplíny patří, že její provozovatelé si jednou za čas položí otázku po vhodnosti jimi používaných metod, po možných podobách budoucího směřování daného oboru a debatují o cílech, kterých by chtěli dosáhnout. Filozofie v tom nepředstavuje výjimku. To, co ji odlišuje, je cosi „navíc“, dodatečná otázka – snad pouze filozofové se v určitých intervalech zajímají o to, jestli vůbec má smysl jejich obor provozovat, jestli je nějak opodstatnitelná a smysluplně vymezitelná jeho pozice v oblasti lidského poznání. Čím je filozofie přínosná? V kontextu zjevně panující a stále rostoucí interdisciplinarity charakterizující vědní prostor počátku 21. století je pochopitelné, že výše uvedené typy otázek jsou kladeny stále častěji. Tak jsem si také zamudroval. V psané podobě ZDE.
čtvrtek, června 26, 2008
Z věd o jazyce XXIII: Co to znamená, že je jazyk jako hra?
"Proč hrajete tak rád šachy?"
"Protože je to jediná věc na světě, kde vidím všechny faktory a rozumím všem pravidlům."
[Robert A. Heinlein, Oni, 1941]
"Teze I
... Tak jako se pravidla šachu aplikují na to, k čemu dochází v průběhu šachové partie, a určují, 'jak se to počítá' (např. jako mat, malá rošáda nebo jednoduše jako tah jezdce z B1 na A3), jazyková pravidla se aplikují na promluvy a dávají jako out-put jejich význam..."
"Souhrnně řečeno, Saussurova známá srovnání jazyka s hrou v šachy nemají s Tezí I vesměs co dělat. Tvrzení, že jazyk je systém, který 'zná jen svůj vlastní řád', bychom neměli přejít bez komentáře. Měli bychom je jednoznačně odmítnout, pokud má implikovat, že jazyk je autonomní, v sobě završený systém pravidel, jejich určitost nezávisí na mimojazykových faktech."
[Petr Koťátko, Interpretace a subjektivita, 2006]
"Protože je to jediná věc na světě, kde vidím všechny faktory a rozumím všem pravidlům."
[Robert A. Heinlein, Oni, 1941]
"Teze I
... Tak jako se pravidla šachu aplikují na to, k čemu dochází v průběhu šachové partie, a určují, 'jak se to počítá' (např. jako mat, malá rošáda nebo jednoduše jako tah jezdce z B1 na A3), jazyková pravidla se aplikují na promluvy a dávají jako out-put jejich význam..."
"Souhrnně řečeno, Saussurova známá srovnání jazyka s hrou v šachy nemají s Tezí I vesměs co dělat. Tvrzení, že jazyk je systém, který 'zná jen svůj vlastní řád', bychom neměli přejít bez komentáře. Měli bychom je jednoznačně odmítnout, pokud má implikovat, že jazyk je autonomní, v sobě završený systém pravidel, jejich určitost nezávisí na mimojazykových faktech."
[Petr Koťátko, Interpretace a subjektivita, 2006]
středa, června 04, 2008
Z věd o jazyce XXI: O významu
Lingvistika je hledání významu.
[B. L. Whorf]
[B. L. Whorf]
Jazykové konvence mohou jen usnadnit shodu komunikativní intence a interpretace (jsou prostředkem komunikativního komfortu, ne zdrojem významu).
[P. Koťátko, parafráze intencionalistického postoje v otázce povahy významu promluvy]
sobota, března 08, 2008
Z věd o jazyce XX: O teorii informace/komunikace
 Na základě krátkého Vítkova postu jsem vyrazil nedávno do hradeckého Centralu na nový film Juliana Schnabela Skafandr a motýl (Le Scaphandre et le papillon). Schnabela mohou čeští diváci znát jak díky Basquiatovi, tak smutnému a tragickému Before Night Falls (momentálně k dostání jako DVD v Levných knihách, hlavní roli ztvárnil čerstvý držitel Oskara Javier Bardem). Poslední Schnabelův film není vůbec jednoduchý. Vítek už psal o zajímavé a výrazné kameře, já přidám velice silný příběh/námět (vnitřní svět muže stiženého locked-in syndromem) nebo netriviální dějovou strukturu, nepodbízivý způsob vyprávění a kladení akcentů. Pokud v brzké době vyšetřím trochu času, zkusím stručně analyzovat významotvornost střídání funkcí kamery a jejího pohybu (např. jestli její užití ve funkci "objektivujícího oka" nějak koreluje s vnitřním stavem hrdiny apod.), dnes chci ale soustředit pozornost na jiný problém.
Děsivost locked-in syndromu spočívá mimo jiné v tom, že pacient je sice při vědomí a častokrát s plně zachovanými kognitivními funkcemi, zároveň je však bohužel quadriplegický a zbaven schopnosti produkovat mluvenou řeč (jazyková schopnost však zůstává neporušena!). Jean-Dominique Bauby, hrdina Schnabelova filmu, byl po mozkové příhodě úplně paralyzován a jediným komunikačním prostředkem mu bylo mrkání levým očním víčkem, jež využíval jako binární logické funkce TRUE/FALSE. Jeho řečová terapeutka se po mnoha "výzkumech a konzultacích" rozhodla, že odemkne Baubyho svět pomocí tabulky grafémů uspořádané na základě frekvence jednotlivých grafémů ve francouzštině (nebylo řečeno, zda-li na základě slovníku nebo statistického výzkumu korpusového typu). Komunikace ve směru Bauby-okolní svět probíhala tak, že Bauby vybíral pomocí mrknutí oka z řady vždy od začátku opakovaného výčtu frekvenčně řazených grafémů francouzštiny. Bauby tak za pomoci zapisovatelky dokonce napíše knihu, která "took about 200,000 blinks to write and each word took approximately two minutes".
Daná situace je velmi zajímavá z hlediska matematické a logizující i klasické lingvistiky a také neurolingvistiky (teorie informace a komunikace, teorie binárního kódování, problém vztahu mluvené a psané řeči ve vztahu k jazyku, afatické a neafatické poruchy atd.). V tomto postu se ale podrobněji zaměřím pouze na problematiku vztahu přirozeného jazyka (češtiny) a teorie informace. Zdá se, že komunikační kód, který zvolila terapeutka (v podání překrásné Marie-Josée Croze), je sice inspirován v základě správnou úvahou, ale představuje "pouhý" počátkek cesty k rozvinutí opravdu efektivního komunikačního prostředku. Je přitom nutné vzít v úvahu, že film nijak netematizuje způsob sestavení dané tabulky, takže se budeme pohybovat v rovině spekulací a instruktážních ilustrací. Ale minimálně zobrazované užívání tabulky trochu napoví a poslouží jako vstupní brána při exkurzu do světa (lingvistické) teorie informace.
V roce 1997, kdy se příběh francouzského žurnalisty J-D. Baubyho odehrál, již měla (nejen francouzská) lingvistika k dispozici velmi mnoho kvalitních údajů o tom, jaké jsou vlastnosti přirozeného jazyka nahlíženého z hlediska obecné teorie informace. Zájem lingvistů o výsledky matematiků pracujících na poli teorie informace a komunikace se totiž objevil záhy po publikování základní práce oboru, Shannonovy Mathematical Theory of Communication (Shannon, 1948). Podobně jako v případě aplikací matematických modelů v oblasti strojového překladu, i v případě teorie informace bylo počáteční nadšení zchlazeno složitostí problematiky, nesporné výsledky však dlouhodobý výzkum přeci jen přinesl. Ukázalo se, že modely přirozeného jazyka pojímaného jako kód (symbolický systém s určitými statisticky relevantními vlastnostmi jako jsou konexita jeho prvků, statistická struktura zprávy, množství informace apod.), které vycházejí např. z markovovských procesů, mohou nejen vypovědět mnoho teoreticky zajímavého o vlastnostech přirozených jazyků a průběhu našeho dorozumívání, ale mohou přinést i spoustu praktického využití (např. Baubyho případ).
Od počátku se výzkumy v oblasti přirozených jazyků týkaly aplikací klíčového pojmu teorie informace, entropie (průměrného množství informace na jeden symbol jazyka, vyjádřené konvenčně v bitech). Bylo vypracováno několik typů metod pro její zjišťování (viz např. Königová, 1965, podrobněji o některých pak v Shannon, 1964 a Newman - Waugh, 1964), jejichž vývoj odrážel uvědomování si, jak složité vztahy existují uvnitř přirozených jazyků i mezi nimi navzájem. A právě to, jak bylo ve Skafandru a motýlovi používáno pomocné tabulky, nám pomůže na některé z těchto vztahů poukázat.
Jak vyplývá z výše uvedeného, úkolem Baubyho terapeutky bylo vymyslet co nejefektivnější způsob, jak z minima pacientových možností vytěžit maximálně efektivní nástroj pro jeho možné vyjádření. Celkem pochopitelně usoudila, že nezbývá nic jiného, než směřovat svou snahu k vystavění kódu založeného na Baubyho schopnosti mrkat jedním okem. Zde se nabízí jako nejjednodušší poskytnout pacientovi tabulku s písmeny zakódovanými do tzv. Morseovy abecedy, samozřejmě - vzhledem k univerzálnímu charakteru morseovky - upravené pro potřeby daného přirozeného jazyka (tj. kódování by se přizpůsobilo statistickým vlastnostem grafémického systému francouzštiny, češtiny atd.). Pacient by pak prostě každé písmeno zakódoval a zapisovatelka by pouze převedla jeho sdělení do grafémické podoby. Tento postup by byl pochopitelně nejrychlejší, ale pro Baubyho také nejnamáhavější - vezmeme-li v úvahu, že základní česká abeceda (zredukovaná o samostatné grafémy pro dlouhé vokály a konsonanty s diakritikou!) vykazuje průměrné zatížení jednoho grafému zhruba 3 mrknutí oka, pak by průměrně dlouhé české slovo (cca 5 - 6 písmen) vyžadovalo 15-18 mrknutí (o tom, že skutečný údaj by nakonec byl přeci jen nižší, níže). Nespornou výhodou tohoto postupu tedy zůstává snadná technická proveditelnosti, největší rychlost kódování a nejspíš i menší kognitivní náročnost pro Baubyho paměť a plánování výpovědí (umožňovalo by to pohodlnější tvorbu v reálném čase), nevýhodou pak relativně velká fyzická náročnost celého procesu.
Další možnou metodou představuje využití binárně koncipovaného algoritmu, který by sloužil jako průvodce hláskovým systémem daného jazyka (co nejpřehledněji vztaženým k jeho grafémové podobě). Ten by byl v základu opřen o kombinaci statistických výzkumů (četnost jednotlivých skupin hlásek i hlásek samotných v textech daného jazyka) a funkčně upravených klasických klasifikací hláskového systému na základě fonologických kritérií. V zájmu co nejmenšího zatížení pacienta bychom při průchodu systémem kódovali NE jako NEMRKNUTÍ, ANO jako MRKNUTÍ. Tak by při opětovném vynechání kvantity byl vokál kódován maximálně dvěma mrknutími (a navíc velice rychle), stejně tak neznělý konsonant, znělý by byl kódován jen jedním mrknutím. Výhodou celého systému je opět jeho technická nenáročnost a při mírném snížení rychlosti vyvažující menší zatížení pacienta (max. počet mrknutí na znak by se snížil na dvě mrknutí, což by při první variantě z hlediska úspornosti překonávaly pouze dva grafémy a vyrovnávaly grafémy čtyři).
Oba výše uvedené modely pracují s principy teorie informace velmi omezeně. Opírají se především o statistická zjištění týkající se četnosti grafémů v textech jazyka (případně fonémů dle fonologických kategorií), při podrobnějším zpracování by pak využívaly zjištění o frekvenci výskytu symbolu v závislosti na pozici ve slově (o tom níže) a při praktické aplikaci by zároveň oba modely přirozeně pracovaly s prediktabilitou následujícího symbolu, jež by ovšem byla ukotvena "pouze" jako znalost v jazykovém povědomí zapisovatelky. K efektivnějšímu využití teorie informace by však nejspíš směřovaly až modely následujícího typu.
Jak už bylo uvedeno výše, teorii informace zajímá statistická struktura zprávy, a to vzhledem k pojmu entropie, což je neurčitost symbolu vyjádřitelná také jako jeho informační hodnota (a tak vztáhnutelná např. k pojmu redundance). Teorie informace mimo jiné zjišťuje, kolik informace připadá průměrně na jeden symbol kódu a jakými vlastnostmi kódu (a vztahy v něm) je tato míra informace ovlivněna. Vlastně ji zajímá předpověditelnost...
Základním východiskem, se kterým pracuje i tabulka z Baubyho případu, je fakt, že jednotlivé symboly se v textech jazyka nevyskytují se stejnou frekvencí. Pravděpodobnost, že se v textu objeví určitý symbol, je u různých symbolů různá. "Míra neurčitosti před obdržením symbolu tedy závisí na počtu možných symbolů a na jejich pravděpodobnostech." (Padučevová, 1965) V případě, že bychom sestavovali základní "baubyovskou tabulku", mohli bychom se řídit právě četnostmi výskytů symbolů v textech (spíš než ve slovníku). V takovém případě by na prvním místě v tabulce pro češtinu stál grafém O (nepočítáme mezeru), druhý by byl grafém E atd. (viz např. Králík, 1985), což by mělo zefektivnit a zrychlit celý proces vyjadřování. Na tomto principu byla vystavěna tabulka ve filmu a koneckonců by se o něj opíral navrhovaný "morseovský" přístup a částečně i přístup "fonologický". Průměrná hodnota neurčitosti H1 = - [p(1)log2p(1) + p(2)log2p(2) + ... p(n)log2p(n)], kde n je počet symbolů v abecedě a p jsou pravděpodobnosti prvního až n-tého symbolu. Problémem tohoto jednoduchého přístupu je, že cenou, kterou platí za svoji jednoduchost, je právě ignorování vztahů v systému symbolů (jejich konexity). Takovýto přístup totiž pojímá symboly ve zprávě jako nezávislé a nezpracovává fakt, že v jazyce musíme počítat s tzv. podmíněnou pravděpodobností. Tak jako se s určitou četností vyskytují v textech jazyka základní symboly, platí to i o jejich řetězcích (matematici mluví v případě přirozeného jazyka o složitých markovovských řetězcích). Můžeme tedy zkoumat vlastnosti digramů (H2), trigramů (H3) atd. To vše samozřejmě v závislosti na velikosti vzorku, z něhož dané informace získáváme (čím větší řetězce, tím více se přibližujeme zjišťování frekvence slov, tedy musíme pracovat skutečně s velkým korpusem dat). Zatímco pro zjištění četnosti jednoduchých nezávislých symbolů stačí relativně malý vzorek (Königová a spol. pracovali se vzorkem 20 000 grafémů, viz Königová, 1965), pro zjišťování digramů a trigramů by takový vzorek už nejspíš dostatečný nebyl. Takovýto model odpovídá více naší intuici, že po grafémech následují další grafémy s nestejnou pravděpodobností. Pokud budeme např. někomu předříkávat tabulku písmen a on odsouhlasí písmeno P, pak můžeme při novém kole prezentace grafémů P v češtině klidně vynechat a (za jisté situace) rovnou přikročit ke grafému O. Vylepšená tabulka by v naší úpravě tedy musela obsahovat "podtabulky" operující minimálně s markovovskými, v lepším případě však přímo se složitými markovovskými procesy. Tak bychom se vyhnuli tomu, že bychom nerespektovali vztahy konexity, které v daném kódu panují.
Tento přístup bychom mohli samozřejmě dále zjemňovat a efektivizovat. Je např. zcela zřejmé, že jinou tabulku bychom potřebovali pro začátky slova, jinou pro jeho zakončení apod. Ukazuje se, že pozice grafému ve slově zřetelně ovlivňuje pravděpodonost jeho výskytu. Přestože je např. O nejfrekventovanější grafém v českých textech, tabulka pro počáteční písmeno slova by ho obsahovala až kolem sedmé pozice (jeho frekvence je silně ovlivněna vysokou frekvencí předložky o, předpony o-, zakončením tvarů ukazovacích zájmen apod.) a obecně byl by relativně osamoceným vokálem, protože frekvence vokálů je vysoká především v zakončení slovních tvarů (díky bohaté flexi češtiny). Stejně tak se mění entropie počátečního písmene v závislosti na frekvenci slov v jazyce (o tom pro češtinu např. Těšitelová, 1965).
Další zjištění, které můžeme využít, je údaj o průměrné délce slova v grafémech. Vezmeme-li v úvahu, že jazyková sdělení jsou do značné míry redundandní (kontext pomáhá posluchači dourčovat prediktabilitu zakončení slov apod.) a zvážíme-li průměrnou délku českého slova, mohou nás do jisté míry zajímat jen statistické vlastnosti a vztahy omezené na zhruba první čtyři grafémy českých slov. Vždy se však pohybujeme v aproximaci a testování, tj. musíme vzít v úvahu např. slovotvorné vlastnosti češtiny - typy předpon, závislost na slovních druzích apod. Podíváme-li se na nejfrekventovanější počáteční grafémy češtiny, zjistíme, že jejich frekvence je dána silnou produktivností předpon, na jejichž počátku stojí. V takovém případě bychom tedy s frekvencí pouhých čtyř prvních grafémů vystačili jen těžko... Atd. atd.
Tento stručný pohled na jednu z praktických aplikací vysoce teoretického jazykovědného výzkumu není samozřejmě vyčerpávající a nejspíš ani nejaktuálnější. Věřím, že existují sofistikované softwarové nástroje, které by, opřené o podrobnější výzkum češtiny, pomohly řešit "Baubyho problém" mnohem elegantněji, než zde bylo naznačeno. Nebohá terapeutka by si za filmem naznačených podmínek mohla dovolit tak maximálně speciální tabulku pro každou pozici ve slově, což by nebylo úplně neefektivní, ale pořád značně krkolomné. Přes veškerou snahu se mi zatím nepodařilo zjistit nic o případném aktuálně probíhajícím lingvistickém výzkumu současné češtiny. Pokud o něm víte nebo máte v šupleti dobrý algoritmus, podělte se :)
Čermák, F. - Křen, M. a kol.: Frekvenční slovník. Praha 2004.
http://en.wikipedia.org/wiki/The_Diving_Bell_and_the_Butterfly (5. 4. 2008)
Königová, M.: Odhad entropie vyšších řádů. Informační bulletin pro otázky jazykovědné. Kvantitativní lingvistika, 6, 1965, s. 17-23.
Králík, J.: Kvantitativní charakteristiky českých grafémů. In: Těšitelová, M. a kol.: Kvantitativní charakteristiky současné češtiny. Praha 1985.
Newman, E. B. - Waugh, N. C.: Redundance textů ve třech jazycích. In: Doležel, L. (ed.): Teorie informace a jazykověda. Praha 1964.
Padučevová, J. V.: Možnosti zkoumání jazyka metodami teorie informace. In: Exaktní metody v jazykovědě. Praha 1965.
Shannon, C. E.: Mathematical theory of Communication. Bell System Technical Journal, Vol. 27, pp. 379–423, 623–656, 1948.
Shannon, C. E.: Predikce a entropie tištěné angličtiny. In: Doležel, L. (ed.): Teorie informace a jazykověda. Praha 1964.
Těšitelová, M.: O entropii počátečních písmen v češtině. Informační bulletin pro otázky jazykovědné. Kvantitativní lingvistika, 6, 1965, s. 31-37.
Daná situace je velmi zajímavá z hlediska matematické a logizující i klasické lingvistiky a také neurolingvistiky (teorie informace a komunikace, teorie binárního kódování, problém vztahu mluvené a psané řeči ve vztahu k jazyku, afatické a neafatické poruchy atd.). V tomto postu se ale podrobněji zaměřím pouze na problematiku vztahu přirozeného jazyka (češtiny) a teorie informace. Zdá se, že komunikační kód, který zvolila terapeutka (v podání překrásné Marie-Josée Croze), je sice inspirován v základě správnou úvahou, ale představuje "pouhý" počátkek cesty k rozvinutí opravdu efektivního komunikačního prostředku. Je přitom nutné vzít v úvahu, že film nijak netematizuje způsob sestavení dané tabulky, takže se budeme pohybovat v rovině spekulací a instruktážních ilustrací. Ale minimálně zobrazované užívání tabulky trochu napoví a poslouží jako vstupní brána při exkurzu do světa (lingvistické) teorie informace.
V roce 1997, kdy se příběh francouzského žurnalisty J-D. Baubyho odehrál, již měla (nejen francouzská) lingvistika k dispozici velmi mnoho kvalitních údajů o tom, jaké jsou vlastnosti přirozeného jazyka nahlíženého z hlediska obecné teorie informace. Zájem lingvistů o výsledky matematiků pracujících na poli teorie informace a komunikace se totiž objevil záhy po publikování základní práce oboru, Shannonovy Mathematical Theory of Communication (Shannon, 1948). Podobně jako v případě aplikací matematických modelů v oblasti strojového překladu, i v případě teorie informace bylo počáteční nadšení zchlazeno složitostí problematiky, nesporné výsledky však dlouhodobý výzkum přeci jen přinesl. Ukázalo se, že modely přirozeného jazyka pojímaného jako kód (symbolický systém s určitými statisticky relevantními vlastnostmi jako jsou konexita jeho prvků, statistická struktura zprávy, množství informace apod.), které vycházejí např. z markovovských procesů, mohou nejen vypovědět mnoho teoreticky zajímavého o vlastnostech přirozených jazyků a průběhu našeho dorozumívání, ale mohou přinést i spoustu praktického využití (např. Baubyho případ).
Od počátku se výzkumy v oblasti přirozených jazyků týkaly aplikací klíčového pojmu teorie informace, entropie (průměrného množství informace na jeden symbol jazyka, vyjádřené konvenčně v bitech). Bylo vypracováno několik typů metod pro její zjišťování (viz např. Königová, 1965, podrobněji o některých pak v Shannon, 1964 a Newman - Waugh, 1964), jejichž vývoj odrážel uvědomování si, jak složité vztahy existují uvnitř přirozených jazyků i mezi nimi navzájem. A právě to, jak bylo ve Skafandru a motýlovi používáno pomocné tabulky, nám pomůže na některé z těchto vztahů poukázat.
Jak vyplývá z výše uvedeného, úkolem Baubyho terapeutky bylo vymyslet co nejefektivnější způsob, jak z minima pacientových možností vytěžit maximálně efektivní nástroj pro jeho možné vyjádření. Celkem pochopitelně usoudila, že nezbývá nic jiného, než směřovat svou snahu k vystavění kódu založeného na Baubyho schopnosti mrkat jedním okem. Zde se nabízí jako nejjednodušší poskytnout pacientovi tabulku s písmeny zakódovanými do tzv. Morseovy abecedy, samozřejmě - vzhledem k univerzálnímu charakteru morseovky - upravené pro potřeby daného přirozeného jazyka (tj. kódování by se přizpůsobilo statistickým vlastnostem grafémického systému francouzštiny, češtiny atd.). Pacient by pak prostě každé písmeno zakódoval a zapisovatelka by pouze převedla jeho sdělení do grafémické podoby. Tento postup by byl pochopitelně nejrychlejší, ale pro Baubyho také nejnamáhavější - vezmeme-li v úvahu, že základní česká abeceda (zredukovaná o samostatné grafémy pro dlouhé vokály a konsonanty s diakritikou!) vykazuje průměrné zatížení jednoho grafému zhruba 3 mrknutí oka, pak by průměrně dlouhé české slovo (cca 5 - 6 písmen) vyžadovalo 15-18 mrknutí (o tom, že skutečný údaj by nakonec byl přeci jen nižší, níže). Nespornou výhodou tohoto postupu tedy zůstává snadná technická proveditelnosti, největší rychlost kódování a nejspíš i menší kognitivní náročnost pro Baubyho paměť a plánování výpovědí (umožňovalo by to pohodlnější tvorbu v reálném čase), nevýhodou pak relativně velká fyzická náročnost celého procesu.
Další možnou metodou představuje využití binárně koncipovaného algoritmu, který by sloužil jako průvodce hláskovým systémem daného jazyka (co nejpřehledněji vztaženým k jeho grafémové podobě). Ten by byl v základu opřen o kombinaci statistických výzkumů (četnost jednotlivých skupin hlásek i hlásek samotných v textech daného jazyka) a funkčně upravených klasických klasifikací hláskového systému na základě fonologických kritérií. V zájmu co nejmenšího zatížení pacienta bychom při průchodu systémem kódovali NE jako NEMRKNUTÍ, ANO jako MRKNUTÍ. Tak by při opětovném vynechání kvantity byl vokál kódován maximálně dvěma mrknutími (a navíc velice rychle), stejně tak neznělý konsonant, znělý by byl kódován jen jedním mrknutím. Výhodou celého systému je opět jeho technická nenáročnost a při mírném snížení rychlosti vyvažující menší zatížení pacienta (max. počet mrknutí na znak by se snížil na dvě mrknutí, což by při první variantě z hlediska úspornosti překonávaly pouze dva grafémy a vyrovnávaly grafémy čtyři).
Oba výše uvedené modely pracují s principy teorie informace velmi omezeně. Opírají se především o statistická zjištění týkající se četnosti grafémů v textech jazyka (případně fonémů dle fonologických kategorií), při podrobnějším zpracování by pak využívaly zjištění o frekvenci výskytu symbolu v závislosti na pozici ve slově (o tom níže) a při praktické aplikaci by zároveň oba modely přirozeně pracovaly s prediktabilitou následujícího symbolu, jež by ovšem byla ukotvena "pouze" jako znalost v jazykovém povědomí zapisovatelky. K efektivnějšímu využití teorie informace by však nejspíš směřovaly až modely následujícího typu.
Jak už bylo uvedeno výše, teorii informace zajímá statistická struktura zprávy, a to vzhledem k pojmu entropie, což je neurčitost symbolu vyjádřitelná také jako jeho informační hodnota (a tak vztáhnutelná např. k pojmu redundance). Teorie informace mimo jiné zjišťuje, kolik informace připadá průměrně na jeden symbol kódu a jakými vlastnostmi kódu (a vztahy v něm) je tato míra informace ovlivněna. Vlastně ji zajímá předpověditelnost...
Základním východiskem, se kterým pracuje i tabulka z Baubyho případu, je fakt, že jednotlivé symboly se v textech jazyka nevyskytují se stejnou frekvencí. Pravděpodobnost, že se v textu objeví určitý symbol, je u různých symbolů různá. "Míra neurčitosti před obdržením symbolu tedy závisí na počtu možných symbolů a na jejich pravděpodobnostech." (Padučevová, 1965) V případě, že bychom sestavovali základní "baubyovskou tabulku", mohli bychom se řídit právě četnostmi výskytů symbolů v textech (spíš než ve slovníku). V takovém případě by na prvním místě v tabulce pro češtinu stál grafém O (nepočítáme mezeru), druhý by byl grafém E atd. (viz např. Králík, 1985), což by mělo zefektivnit a zrychlit celý proces vyjadřování. Na tomto principu byla vystavěna tabulka ve filmu a koneckonců by se o něj opíral navrhovaný "morseovský" přístup a částečně i přístup "fonologický". Průměrná hodnota neurčitosti H1 = - [p(1)log2p(1) + p(2)log2p(2) + ... p(n)log2p(n)], kde n je počet symbolů v abecedě a p jsou pravděpodobnosti prvního až n-tého symbolu. Problémem tohoto jednoduchého přístupu je, že cenou, kterou platí za svoji jednoduchost, je právě ignorování vztahů v systému symbolů (jejich konexity). Takovýto přístup totiž pojímá symboly ve zprávě jako nezávislé a nezpracovává fakt, že v jazyce musíme počítat s tzv. podmíněnou pravděpodobností. Tak jako se s určitou četností vyskytují v textech jazyka základní symboly, platí to i o jejich řetězcích (matematici mluví v případě přirozeného jazyka o složitých markovovských řetězcích). Můžeme tedy zkoumat vlastnosti digramů (H2), trigramů (H3) atd. To vše samozřejmě v závislosti na velikosti vzorku, z něhož dané informace získáváme (čím větší řetězce, tím více se přibližujeme zjišťování frekvence slov, tedy musíme pracovat skutečně s velkým korpusem dat). Zatímco pro zjištění četnosti jednoduchých nezávislých symbolů stačí relativně malý vzorek (Königová a spol. pracovali se vzorkem 20 000 grafémů, viz Königová, 1965), pro zjišťování digramů a trigramů by takový vzorek už nejspíš dostatečný nebyl. Takovýto model odpovídá více naší intuici, že po grafémech následují další grafémy s nestejnou pravděpodobností. Pokud budeme např. někomu předříkávat tabulku písmen a on odsouhlasí písmeno P, pak můžeme při novém kole prezentace grafémů P v češtině klidně vynechat a (za jisté situace) rovnou přikročit ke grafému O. Vylepšená tabulka by v naší úpravě tedy musela obsahovat "podtabulky" operující minimálně s markovovskými, v lepším případě však přímo se složitými markovovskými procesy. Tak bychom se vyhnuli tomu, že bychom nerespektovali vztahy konexity, které v daném kódu panují.
Tento přístup bychom mohli samozřejmě dále zjemňovat a efektivizovat. Je např. zcela zřejmé, že jinou tabulku bychom potřebovali pro začátky slova, jinou pro jeho zakončení apod. Ukazuje se, že pozice grafému ve slově zřetelně ovlivňuje pravděpodonost jeho výskytu. Přestože je např. O nejfrekventovanější grafém v českých textech, tabulka pro počáteční písmeno slova by ho obsahovala až kolem sedmé pozice (jeho frekvence je silně ovlivněna vysokou frekvencí předložky o, předpony o-, zakončením tvarů ukazovacích zájmen apod.) a obecně byl by relativně osamoceným vokálem, protože frekvence vokálů je vysoká především v zakončení slovních tvarů (díky bohaté flexi češtiny). Stejně tak se mění entropie počátečního písmene v závislosti na frekvenci slov v jazyce (o tom pro češtinu např. Těšitelová, 1965).
Další zjištění, které můžeme využít, je údaj o průměrné délce slova v grafémech. Vezmeme-li v úvahu, že jazyková sdělení jsou do značné míry redundandní (kontext pomáhá posluchači dourčovat prediktabilitu zakončení slov apod.) a zvážíme-li průměrnou délku českého slova, mohou nás do jisté míry zajímat jen statistické vlastnosti a vztahy omezené na zhruba první čtyři grafémy českých slov. Vždy se však pohybujeme v aproximaci a testování, tj. musíme vzít v úvahu např. slovotvorné vlastnosti češtiny - typy předpon, závislost na slovních druzích apod. Podíváme-li se na nejfrekventovanější počáteční grafémy češtiny, zjistíme, že jejich frekvence je dána silnou produktivností předpon, na jejichž počátku stojí. V takovém případě bychom tedy s frekvencí pouhých čtyř prvních grafémů vystačili jen těžko... Atd. atd.
Tento stručný pohled na jednu z praktických aplikací vysoce teoretického jazykovědného výzkumu není samozřejmě vyčerpávající a nejspíš ani nejaktuálnější. Věřím, že existují sofistikované softwarové nástroje, které by, opřené o podrobnější výzkum češtiny, pomohly řešit "Baubyho problém" mnohem elegantněji, než zde bylo naznačeno. Nebohá terapeutka by si za filmem naznačených podmínek mohla dovolit tak maximálně speciální tabulku pro každou pozici ve slově, což by nebylo úplně neefektivní, ale pořád značně krkolomné. Přes veškerou snahu se mi zatím nepodařilo zjistit nic o případném aktuálně probíhajícím lingvistickém výzkumu současné češtiny. Pokud o něm víte nebo máte v šupleti dobrý algoritmus, podělte se :)
Čermák, F. - Křen, M. a kol.: Frekvenční slovník. Praha 2004.
http://en.wikipedia.org/wiki/The_Diving_Bell_and_the_Butterfly (5. 4. 2008)
Königová, M.: Odhad entropie vyšších řádů. Informační bulletin pro otázky jazykovědné. Kvantitativní lingvistika, 6, 1965, s. 17-23.
Králík, J.: Kvantitativní charakteristiky českých grafémů. In: Těšitelová, M. a kol.: Kvantitativní charakteristiky současné češtiny. Praha 1985.
Newman, E. B. - Waugh, N. C.: Redundance textů ve třech jazycích. In: Doležel, L. (ed.): Teorie informace a jazykověda. Praha 1964.
Padučevová, J. V.: Možnosti zkoumání jazyka metodami teorie informace. In: Exaktní metody v jazykovědě. Praha 1965.
Shannon, C. E.: Mathematical theory of Communication. Bell System Technical Journal, Vol. 27, pp. 379–423, 623–656, 1948.
Shannon, C. E.: Predikce a entropie tištěné angličtiny. In: Doležel, L. (ed.): Teorie informace a jazykověda. Praha 1964.
Těšitelová, M.: O entropii počátečních písmen v češtině. Informační bulletin pro otázky jazykovědné. Kvantitativní lingvistika, 6, 1965, s. 31-37.
sobota, března 01, 2008
Z věd o jazyce XIX: O češtině dnes
 "Česká komise UNESCO, Univerzita Karlova v Praze a Akademie věd ČR uspořádaly u příležitosti vyhlášení 21. února organizací UNESCO Mezinárodním dnem mateřského jazyka kolokvium s názvem Potřebujeme češtinu? A jakou?" Vystoupily na něm významné postavy současné české lingvistiky jako Petr Sgall (propagátor velmi nekonvenčních přístupů k pojímání vztahu spisovné češtiny a jejích nespisovných útvarů), Jiří Kraus (přední český badatel v oblasti rétoriky), Oldřich Uličný (badatel v oblasti jazykové kultury), Jana Hoffmannová (propagátorka komunikačně orientovaných lingvistických modelů) apod. Kompletní zvukový záznam kolokvia si díky záslužnému projektu ČRo Leonardo můžete stáhnout ZDE, několik dní předtím uvedené Vstupte s prof. Jiřím Krausem pak ZDE. Posouzení kvality příspěvků z hlediska jejich obsahu i způsobu prezentace ponechám na vás...
úterý, února 05, 2008
Z věd o jazyce XVIII: O čtení
Po nahlédnutí do literatury o čtenářských dovednostech by se nezasvěcený člověk mohl domnívat, že cílem čtení je konvertovat tištěný text do řeči. Ovšemže tomu tak není: cílem čtení je porozumět textu (a snad ho i vychutnat)".
[R. Ellis]
Čeští studenti jsou podprůměrní čtenáři [...] České děti totiž mají velké problémy pochopit text, analyzovat ho a vybrat z něj podstatné věci. Mnohem lépe tuto dovednost - čtenářskou gramotnost - zvládají malí Finové či Britové. I v mezinárodním srovnání jsou Češi až na 26. místě z 56 zemí, které v loňském roce porovnávala OECD ve svém průzkumu PISA. To testuje patnáctileté žáky v dovednostech, které člověk uplatní v životě. Právě čtenářská gramotnost je jednou z nejdůležitějších schopností, kterou by si člověk měl odnést už ze základní školy.
[HN.IHNED.CZ 24. 1. 2008]
[R. Ellis]
Čeští studenti jsou podprůměrní čtenáři [...] České děti totiž mají velké problémy pochopit text, analyzovat ho a vybrat z něj podstatné věci. Mnohem lépe tuto dovednost - čtenářskou gramotnost - zvládají malí Finové či Britové. I v mezinárodním srovnání jsou Češi až na 26. místě z 56 zemí, které v loňském roce porovnávala OECD ve svém průzkumu PISA. To testuje patnáctileté žáky v dovednostech, které člověk uplatní v životě. Právě čtenářská gramotnost je jednou z nejdůležitějších schopností, kterou by si člověk měl odnést už ze základní školy.
[HN.IHNED.CZ 24. 1. 2008]
pátek, října 19, 2007
Od všeho trochu...
Věci se mají bohužel tak, že od začátku semestru se mi nedaří najít čas na trochu podrobnější psaní. A nerad bych svůj blog začal plnit řadou výkřiků do tmy nebo z něj udělal album pro filatelisty ducha. Přitom by bylo o čem psát - hlavou mi naštěstí prošlo leccos z lingvistiky, literatury, filmu i hudby. Jenže z nánosu valících se dnů vykukují spíš jen fragmenty a torza...
 Už dlouho se mi nestalo, že bych měl rozečtených několik vcelku dobrých knih, mezi kterými bych přeskakoval a žádná mě nedokázala připoutat a donutit ke zhltnutí. Američtí bohové Neila Gaimana jsou napodruhé ještě lepší než kdysi dávno, ale přesto..., povídky z různých antologií splývají nepříjemně jedna s druhou, Utažení šroubu Henryho Jamese vypadá slibně, ale bylo by třeba ji prostě přečíst a ne nad ní usínat večer co večer a nehnout se tak prakticky z místa... Teprve včerejší pustá a tichá noc mě zlákala a já přečetl znova Machenovy Bílé lidi - jednu z nejpodivnější knih, jaká se mi kdy dostala do rukou. Artur Machen je spisovatelem zázraku, zázraku děsivého a potemnělého, spisovatelem svatosti a extáze hříchu, hororu kořenícího v archetypální přitažlivosti pohádek, zneklidňujících legend a mýtů a v pohledu za oponu přehledného světa, za kterou víří věci, na které se bojíme byť jen pomyslet. Podobně jako když jsem v létě četl jeho slavného Velikého boha Pana, zmocňovala se mě i včera pomalu hrůza živící se tušením a nejistotou. "Podoby" Zla, jež Machen vykreslí v příběhu malé dívky z Bílých lidí nebo záhadné ženy z Velikého boha Pana, jsou možná tím nejděsivějším, co jsem zatím v literatuře objevil, hlavně svou nadčasovostí... Sugestivnost a tematika jeho děl jej podle mého názoru jednoznačně spojuje s dalším velkým Mistrem vizí, Williamem Blakem. Machenova díla představují hrozivý škleb zastiňující valnou většině hororových povídek a románů. Když skládal Stephen King v povídce Crouch End poklonu Howardu P. Lovecraftovi, patřila možná daleko spíš Arthuru Machenovi, prvnímu mezi autory zla číhajícího u známých a rovných cest... Doufám, že Machena budu moct brzy představit podrobněji!
 Od mého posledního filmového přehledu uběhlo už hodně času a mezi pestrou směsicí filmů, které jsem za tu dobu viděl - od příjemných retro vzpomínek, jako je postapokalyptická Planeta opic, až po výtečnou Pulp Fiction -, stojí za připomenutí dva momenty: Vítkům liberecký filmový maraton a báječný Faunův labyrint Guillerma del Tora (trailery).
Se svým psaním o filmech mám potíž - je především plné dojmů. Doufal jsem, že kvalitní rozbory z libereckého maratonu se co nejdřív objeví na Fantomu, ale chlapci byli poněkud zaneprázdnění plněním karlovarských závazků, takže zatím nezbývá než doufat a spokojit se s mou kratičkou upomínkou. Tématem maratonu byl méně známý Nový Hollywood, takže v seznamu filmů zazářila jména tehdy mladých a začínajících Martina Scorseseho, Briana de Palmy, ale také již známého Roberta Altmana a dalších. Pro mě jako fanouška a beznadějného filmového amatéra opět ohromný zážitek. Ať už šlo o rebelující a existencialistický Vanishing Point, ostře kritickou dlouhou metráž Nashvillu nebo odlehčenější The Long Goodbye, černou komedii Hi, mom!, první Scorseseho movie Who's That Knocking at My Door, Lumetovo Dog Day Afternoon, Schatzbergova Scarecrow, nebo Ashbyho The Last Detail. A zajímavý byl tento výběr nejen proto, že mi umožnil vhlédnout do začátků tvorby mých oblíbenců režírujících (de Palma, Scorsese) či hrajících (Pacino, de Niro, Nicholson), nebo proto, že jsem mohl vidět fimy kultovní (Vanishing Point) a slavné (Nashvill). Byl jsem nadšený hlavně z intenzity těch filmů, z jejich (neploché!) angažovanosti a efektu autenticity, které podporoval místy až polodokumentaristický styl, jinde skvělé herecké výkony (uchvátil mě hlavně Al Pacino), a především silná témata. Nejsilněji na mě zapůsobil svou vizualitou a silným závěrem Scarecrow. Mnohým z těchto filmů byla společné zajímavá směsice (černého) humoru a syrového dramatu (např. Hi, mom!, Dog Day Afternoon, ale i Nashvill), nejdůležitější byl ale pro mě pocit, že se koukám na pokusy o osobité vyjádření, na něco, co nemá jen "pobavit" a zaplácnout čas...
Loňské/letošní překvapení Guillerma del Tora - El laberinto del fauno, Faunův labyrint, je nejen tím druhým velkým zážitkem, ale zároveň je také svázáno s již zmiňovaným Arthurem Machenem, z jehož poetiky se Faunův labyrint vydatně (ale přiznaně) napájel! Na pohádkovém půdorysu vystavěný (a proto také typově čitelný, nikoliv povrchní) příběh malé dívenky Ofélie, dívky dvou světů, byl uchvacující nejen vizualitou a některými hereckými výkony, ale především tématem a prostotou jeho podání. Vyvážené propojení surovosti a snové pohádkovosti, jejichž průsečíkem byl Oféliin "svět" a její osud, je tou nejlepší pohádkou o pohádkách, jakou jsem kdy viděl. Neveselou, tragickou, okouzlující...
Nejen proto je fantastickým příslibem del Torův záměr konečně natočit Lovecraftovo At the Mountains of Madness!
 Tenhle stručný přehled zmatku mých posledních dnů ukončním pár řádky týkajícími se věd o jazyce. Za zmínku stojí především dvě věci:
1) Česká kognitivní lingvistika se rozrostla o další práci, a sice Nádobu plnou řeči od Ireny Vaňkové z Ústavu českého jazyka a teorie komunikace FF UK v Praze. Po Co na srdci, to na jazyku, jež byla dílem autorského kolektivu a která byla první původní českou monografií s tématem kognitivní lingvistiky, jde o další významný přírůstek tohoto ve světě již dostatečně etablovaného přístupu ke zkoumání jazyka. Irena Vaňková se v duchu svých předchozích zkoumání snaží postihnout specifikum českého jazykového obrazu světa, v tomto případě metalingvisticky českého jazykového obrazu řeči jako základního způsobu našeho pobývání ve světě. Už samotný nápad zaměřit se na konceptualizaci řeči považuji za nesmírně zajímavý (Irena Vaňková mi svou prací"ukradla" nápad věnovat se tématu metaforizace jazyka:)), protože tento přístup tematizuje nejen specifika českého pojetí řeči, ale je zároveň studií metodologickou, tedy nahlédnutím vlastního oboru a jeho filosofických základů (viz citát George Lakoffa). Pokusím se co nejdřív nahlédnout až na dno Nádoby plné řeči a napsat na ni krátkou recenzi.
2) Druhou zajímavou událostí je konání konference Language, Communication and Cognition, která se uskuteční od 4. do 7. 8. 2008 v anglickém Brightonu. Už fakt, že mezi hlavní řečníky bude patřit George Lakoff (University of California v Berkeley), v současné době asi největší ikona kognitivní lingvistiky, nebo Michael Tommasello (Max Planck Institute for Evolutionary Anthropology v Lipsku), významný představitel výzkumu v oblasti osvojování jazyka, je příslibem mimořádně zajímavé události.
Naštěstí ani české aktivity v oblasti kognitivní vědy (včetně lingvistiky) nejsou zanedbatelné. Nedávno uskutečněná konference Kognice 2007, na které jsem se podílel jako spolupořadatel, může snad posloužit jako důkaz (krátká zpráva o ní je ZDE).
A mě zaměstnává vztah jazyka/řeči a kognice také čím dál víc. Snažím se proniknout hlouběji do základů oboru neuro- a psycholingvistiky a připravit první náčrt možného výzkumu. V současné době jsem vypsal diplomovou bakalářskou práci na téma Sclerosis multiplex a problém řeči/jazyka: základní přehled, která by měla přispět k základnímu zmapování této složité a v Česku zatím nepříliš probádané oblasti. Zároveň by tato práce měla být součástí většího souboru aktivit, jež by měly vyústit ve skutečný neuro- a psycholingvistický experimentální výzkum. Snad se věc podaří...
pátek, října 05, 2007
Z věd o jazyce XVII: Základní pojmy analytické filosofie
 Analytická filosofie se definitivně usídlila v našich zemích. Filosofický proud, který je někdy s lehkou nadsázkou definován jako filosofie pofregovská (rozuměj jím inspirovaná a na něj navazující), má za sebou už více než 100 let existence. Za tu dobu prošla mnohými proměnami, zvraty a vydobyla si ve světě pozici jednoho z hlavních proudů současného filosofického myšlení. V Česku se ji sice už od padesátých let snažil propagovat např. Ladislav Tondl a pod rouškou problematické buržoazní filosofie vědy pronikla k českému čtenáři např. ve formě sborníků Filosofie vědy nebo výborů z prací Russellových či Carnapových. Oficiálně však pěstována nebyla - na to nejspíš nebyla dost marxistická. Přesto se dočkala reflexe - právě na půdě logiky, lingvistiky apod. Od 90. let se situace začala výrazně měnit a analytická filosofie začala být soustavnou péčí těch, kteří o ní věděli a soukromě se jí zabývali, popularizována. Dnes už je běžně provozována na stránkách Filosofického časopisu nebo slovenského Organonu F (na rozdělení Česka a Slovenska se v této oblasti naštěstí moc "nehrálo"), ve Filosofickém ústavu AV ČR existuje samostatné oddělení analytické filosofie a skupina věnující se logice se pouze jinak jmenuje, protože dvě oddělení analytické filosofie by nepůsobila dobře:) Jako jisté završení této integrace analytické filosofie do českého filosofického myšlení lez vnímat nedávné vydaní slovníku Základní pojmy analytické filosofie jazyka a mysli. Je signálem, že prostor existuje a je na čase poskytnout orientaci těm, kteří do něj chtějí vstoupit. Je jich naštěstí zřejmě víc a víc...
Recenzi, kterou jsem sepsal spolu s Lukášem Zámečníkem z olomoucké katedry filosofie a která vyjde v dalším čísle časopisu Aluze si můžete přečíst ve formátu HTML [ZDE].
úterý, září 04, 2007
Z věd o jazyce XVI: Neurolingvistika a psycholingvistika 2
 O psycholingvistice a neurolingvistice, dvou tzv. pomezních oborech, které mě momentálně mimořádně zajímají, jsem na tomto blogu už několikrát psal. Zatímco ve světě mají psycho- i neurolingvistika už svou bohatou historii a je možné je bezesporu zahrnout do stále zajímavějšího "balíku" tzv. kognitivních věd, v Česku se jim přes bouřlivý rozvoj v posledních letech zatím příliš nedaří. Signifikantní je především fakt, že až na výjimky se jejich tematice podrobněji věnují především specialisté z oboru psychologie a neurologie (zejména logopedie), lingvisté pomálu. V recenzi na velmi dobrou knihu britského psycholingvisty Gerryho T. M. Altmana jsem připomněl i lingvistické snahy zejména Ivy Nebeské a Jana Průchy, jednalo se však o vzácné "anomálie" v českém jazykovědném myšlení, navíc v případě Ivy Nebeské záhy orientované spíše komunikačně-pragmatickým směrem než soustředěné na experimentální tradici. Neurolingvistika na tom je v českých zemích ještě hůř. Jediným lingvistou, který však zase vstoupil do povědomí obou těchto oborů, byl již před lety všestraný Rus Roman O. Jakobson, a to zejména svými pracemi věnujícími se vývoji řeči u dětí a pracemi o afáziích, jež byly zase inspirovány výzkumy slavného ruského neuropsychologa Alexandra R. Luriji.
V posledních letech se sice v Česku objevilo pár nadějných psycholingvistů, ti však téměř bez výjimky okamžitě zmizeli za hranicemi, protože nikde jinde se vstoupit kvalitně do problému nedalo (Denisa Bordag, Barbara Schmiedtová, Filip Smolík), neurolingvistika se probírá ještě pomaleji...
Předzvěstí lepších časů by mohla být (doufám!) bohulibá snaha několika Mladých (studentů Univerzity Karlovy v Praze, pracovníků Ústavu pro jazyk český a pracovníků Psychologického ústavu), kterým se letos podařilo zorganizovat Letní školu lingvistiky v Dačicích. Ta se totiž věnovala právě tématům psycho- a neurolingvistickým a jejím cílem bylo poskytnout mladým badatelům v této oblasti možnost uvést své kolegy do problematiky (a tak obory zpopularizovat), případně se vzájemně seznámit s vlastními aktuálně probíhajícími výzkumy.
Nepodobalo se to žádným podobným "konferencím", které jsem zatím zažil (ať už z hlediska kvality a zajímavosti přednášek, nebo s ohledem na kvalitu sekce "posterové", rozuměj hospodské:)). Zkrátka - povedlo se to dokonale...
Moje maličkost ve spolupráci s kolegou Danem Faltýnkem přispěla workshopem na téma Popis mluvy afatiků. Prezentaci první - obecné části naleznete ve formátu ppt [ZDE]. Pár mých dalších fotografií pak [ZDE].


Předzvěstí lepších časů by mohla být (doufám!) bohulibá snaha několika Mladých (studentů Univerzity Karlovy v Praze, pracovníků Ústavu pro jazyk český a pracovníků Psychologického ústavu), kterým se letos podařilo zorganizovat Letní školu lingvistiky v Dačicích. Ta se totiž věnovala právě tématům psycho- a neurolingvistickým a jejím cílem bylo poskytnout mladým badatelům v této oblasti možnost uvést své kolegy do problematiky (a tak obory zpopularizovat), případně se vzájemně seznámit s vlastními aktuálně probíhajícími výzkumy.
Nepodobalo se to žádným podobným "konferencím", které jsem zatím zažil (ať už z hlediska kvality a zajímavosti přednášek, nebo s ohledem na kvalitu sekce "posterové", rozuměj hospodské:)). Zkrátka - povedlo se to dokonale...
Moje maličkost ve spolupráci s kolegou Danem Faltýnkem přispěla workshopem na téma Popis mluvy afatiků. Prezentaci první - obecné části naleznete ve formátu ppt [ZDE]. Pár mých dalších fotografií pak [ZDE].


sobota, června 30, 2007
Z věd o jazyce XV: 45. kongres komputační lingvistiky
 Přestože se matematické a komputační lingvistice nevěnuji, už párkrát jsem se ve svých příspěvcích vkradl do krámu algebraikům a statistikům jazyka. Polehčující okolností mi snad může být, že především proto, abych vyjádřil obdiv jejich práci. Myslím, že jejich směřování k exaktnosti může být vzorem každému, kdo se o otázky jazyka a jazykovědy zajímá. Přitažlivé mi přitom připadá zejména budování určitého (častokrát obecného) modelu jazyka zapojené do širšího - interdisciplinárního kontextu a orientované k aplikovatelnosti. Číst si v textech takto uvažujících lingvistů může být pro ty "nematematické" v mnohém inspirativní, protože lingvistika už nesmí být pro příště izolovanou vědou. A fakt, že i tzv. počítačová jazykověda má své problémy, nejasnosti a slabá místa, představuje hlavně výzvu, nikoliv důvody k odmítání. Domnívám se totiž, že jazykověda stojí stejně jako mnoho jiných věd před výzvou k nacházení trans-jazyka pro popis světa, člověka a jeho místo v něm nevyjímaje. Jak říká Gerry Altmann (mimochodem lingvista poučený komputačními modely), "jazyk je okno, z něhož se můžeme vyklonit a dotknout se svých myslí". Dokážeme-li toto naše rozumění modelovat do fungující podoby "jazykových uživatelů", tím lépe pro nás.
Komputační lingvistika je jedním z oborů, který vznikl na přelomu polovin 20. století a který tuto modelační ambici má. Stejně tak má své už neopomenutelné místo v tradici české jazykovědy. I proto se letošní 45th Annual Meeting of the Association for Computational Linguistics konal v Praze. V jeho velmi obsáhlém programu naleznete příspěvky zahrnující strojový překlad, modelování jazyka, otázky týkající se parsingu, strojového "učení" atd. Na oficiálních stránkách konference jsou k nahlédnutí i abstrakty jednotlivých příspěvků, a to i těch, které byly součástí studentských workshopů. Krátké představení konference slovy šéfa jejího organizačního týmu Prof. PhDr. Evy Hajičové, DrSc., naleznete na stránkách Českého rozhlasu Leonardo, kde je rovněž odkaz na oficiální stránky konference.
No a pro ty, kterým zní spojení matematická a komputační lingvistika hrozivě, mám jeden tip: je jím delší rozhovor (zde ve formátu MP3) s již zmiňovanou Evou Hajičovou, který zazněl 26. 9. 2006 v rozhlasovém pořadu Vstupte! Možná během něj zjistíte, že i lingvistika může být zajímavou a užitečnou vědou s velkým V:-)
No a pro ty, kterým zní spojení matematická a komputační lingvistika hrozivě, mám jeden tip: je jím delší rozhovor (zde ve formátu MP3) s již zmiňovanou Evou Hajičovou, který zazněl 26. 9. 2006 v rozhlasovém pořadu Vstupte! Možná během něj zjistíte, že i lingvistika může být zajímavou a užitečnou vědou s velkým V:-)
sobota, června 09, 2007
Z věd o jazyce XIV: literatura a filosofie jazyka 1
„Je-li úlohou filosofie zlomit moc slova nad lidským duchem prostřednictvím odhalení omylů, které se týkají vztahů pojmů a které v důsledku užití jazyka vznikají často téměř nevyhnutelně, a to tím, že osvobodí myšlenky od toho, čím je zatěžuje čistě povaha výrazových prostředků, pak by mohlo být moje pojmové písmo, dále rozpracované pro tyto účely, filosofům užitečným nástrojem.“
[Gottlob Frege, Pojmové písmo, 1879]
"A jak jste, pane starosto, dospěl k tomu pozoruhodnému závěru?"
"To bylo poměrně jednoduché. Stačilo použít onoho prostředku, na který se často zapomíná - zdravého rozumu. Abyste věděli, existuje oblast lidského vědění známá jako symbolická logika, a ta se dá použít k odstranění všelijakého zbytečného balastu, který zamořuje lidský jazyk."
"A co s ní má být?"
"Já jsem ji použil."
[Isaac Asimov, Nadace, 1951]
[Gottlob Frege, Pojmové písmo, 1879]
"A jak jste, pane starosto, dospěl k tomu pozoruhodnému závěru?"
"To bylo poměrně jednoduché. Stačilo použít onoho prostředku, na který se často zapomíná - zdravého rozumu. Abyste věděli, existuje oblast lidského vědění známá jako symbolická logika, a ta se dá použít k odstranění všelijakého zbytečného balastu, který zamořuje lidský jazyk."
"A co s ní má být?"
"Já jsem ji použil."
[Isaac Asimov, Nadace, 1951]
pátek, května 25, 2007
Z věd o jazyce XIII: co modelujeme čím?
Jako generativní gramatika není modelem jazykového chování, tak na druhé straně Markovův model není modelem gramatiky jazyka.
[Jan Průcha, Problémy teorie psycholingvistiky, 1970]
[Jan Průcha, Problémy teorie psycholingvistiky, 1970]
pondělí, května 07, 2007
Z věd o jazyce XII: status slova
Slovo je bytostně psychickou kategorií.
[Jerry A. Fodor, Psychosemantics: The Problem of Meaning in the Philosophy of Mind, 1987]
[Jerry A. Fodor, Psychosemantics: The Problem of Meaning in the Philosophy of Mind, 1987]
pátek, dubna 20, 2007
Z věd o jazyce XI: O člověku, stroji a rozumění
Centrálu tvoří počítač s velkou schopností učit se. Příliš průhledné, běžné, často se vyskytující přirovnání nebo kryptonymy má v paměti nepochybně zkatalogizované. Postačí, aby se daná narážka objevila dvakrát, třikrát v různých kontextech - a už ji počítač pochopí. Šifrovaný jazyk, který zde používají lidé pro sdělování důvěrných informací, musí být proto dynamickým, proměnlivým, trvale neexistujícím, ale vznikajícím a mizejícím během hovoru, efemérním, dočasným systémem narážek, odvolávajícím se na paměť a erudici, pronikavost a schopnost asociovat. Mohou jej tedy užívat pouze lidé, jejichž inteligenci se není schopen vyrovnat ani dokonalý umělý systém.
[Janusz A. Zajdel, Edenie, 1984]
pondělí, dubna 16, 2007
Z věd o jazyce X: O cestě k významům 1
V psychologii může člověk behaviouristou být nebo nebýt, ale v lingvistice nemá na vybranou.
[Willard Van Orman Quine, Hledání pravdy, 1990]
[Willard Van Orman Quine, Hledání pravdy, 1990]
čtvrtek, listopadu 30, 2006
Z věd o jazyce IX: Strojový překlad, lidská řeč a ministerstvo obrany
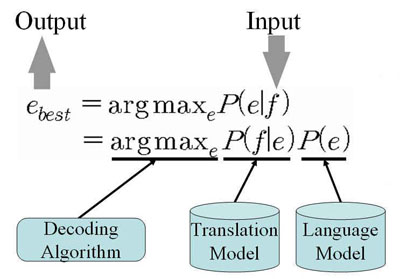 Před nedávnem se objevila v Lidových novinách v sekci Věda zpráva s názvem Nejlepší překladatel se opičí o tom, že kvalita strojového překladu se zase o kousek přiblížila tomu dobře provedenému lidskému. Což o to, podobné zprávy o novinkách ze světa vědy se v tisku objevují poměrně často. Jejich problém ale spočívá především ve skutečnosti, že v mnoha případech se jedná o přejaté zprávy o zprávách (o jiných zprávách atd.). Výsledkem pak mnohdy bývá, že informační hodnota takového článku je kvůli velkému zjednodušení buď velmi nízká nebo i zavádějící. S danou zprávou je to ale v určitém ohledu trochu jiné. Zaujala mě především díky dvěma úzce souvisejícím faktům: za prvé se v ní operuje s termínem, který může nepoučeným konotovat představy, které nejsou úplně přesné (přestože je užití tohoto termínu z technického hlediska korektní a náležité!), za druhé se tu možná implicitně říká něco o jazyce a řeči obecně, tj. nejen z hlediska jejich počítačového zpracování, běžnému smrtelníkovi i tak dost vzdáleného. O co tedy jde.
I letos vyhlásila agentura DARPA (což je mimochodem zkratka pro The Defense Advanced Research Projects Agency, tj. agenturu ministerstva obrany USA, která má na starosti vědecký výzkum aplikovatelný v oblasti vojenství) soutěž o nejlepší program strojového překladu textů. Není to v žádném případě poprvé, kdy je de facto lingvistický projekt financován ze zdrojů určených na obranu a vojenský výzkum. Klasickým příkladem jsou například slavné Chomského Syntaktické struktury, které financovaly organizace americkým letectvem počínaje a námořnictvem konče. Oblast počítačového zpracování jazyka a automatizovaného překladu je totiž už od počátku svého vývoje mimořádně pečlivě sledována právě vojenskými kruhy a v dnešní době je k ní opět obracena pozornost v souvislosti s fenoménem terorismu. Počátky strojového překladu, které můžeme datovat již do prvních roků padesátých let dvacátého století, totiž zcela nepochybně souvisely s tzv. studenou válkou a tehdejším vědecko-technickým soupeřením světových mocností.
Na vlastním výzkumu možností strojového překladu se záhy začalo pracovat i v tehdejším Československu. Z lingvistů se na něm podílela především skupina organizovaná kolem Petra Sgalla, osobnosti, která je v české lingvistice téměř synonymem pro algebraickou jazykovědu. V průběhu téměř padesáti let dosáhl tento tým (J. Panevová, E. Hajičová, E. Buráňová, S. Machová atd. atd.) mnoha úspěchů a uznání nejen v kontextu domácím - kde vlastně ani nebylo možné hovořit o nějaké alternativě - ale i v zahraničí. Přes všechny obrovské naděje, které byly v počátcích strojové lingvistiky do tohoto oboru vkládány, a o to větší pády, jež po vystřízlivění z těchto představ následovaly, se podařilo výzkum na tomto poli u nás nejen zachovat, ale i rozvinout a vybudovat tak silnou tradici, která je nesena několika významnými pracovišti, jako jsou například Ústav teoretické a komputační lingvistiky, Ústav formální a aplikované lingvistiky nebo Ústav českého národního korpusu.
Přestože zájem o strojovou lingvistiku byl motivován především praktickými cíli, je tato oblast mimořádně zajímavá z hlediska teoretické jazykovědy. Pokus zpracovat systém jazyka formálně za pomoci matematicko-informatických metod položil před jazykovědce ohromnou výzvu. V duchu Chomského návrhů je možné říct, že přišla chvíle, kdy lingvisté museli při popisu jazyka explicitně vyjádřit mnohé z toho, co bylo předpokládáno jako samozřejmé, že museli jasně a schematicky formulovat základní strukturní vlastnosti jazyků a soubory pravidel, o něž se může následná produkce řeči opřít - to všechno samozřejmě ve smyslu modelů "černé skříňky" a s omezením na to, co Chomsky definoval jako jazykovou kompetenci. Později, v souvislosti s tzv. pragmatickým nebo také komunikačním obratem v jazykovědě, se pochopitelně začal zájem části lingvistů modelujících jazykovou kompetenci pomocí matematických nástrojů obracet i k problémům spjatým s jeho užíváním, což byl jeden z procesů, který pomáhal formovat mosty k transdisciplinárním zkoumáním v rámci kognitivní vědy.
Z obecného hlediska je důležité především to, že v pozadí těchto snah stojí samozřejmě implicitně úvaha, co přesně je těmito postupy modelováno a jaké nároky, případně předpoklady adekvátnosti na tyto modely klást. Můžeme si například položit otázku, do jaké míry pouze vytváříme algoritmická schémata, která na základě požadavku co největší efektivity a mohutnosti dokáží analyzovat lineární vstup v podobě jazykového kódu a pomocí implementovaných "rozhodovacích" procedur je desambiguovat, vytvořit významový "zápis" v jazyce sloužícím jako terra comparationis a syntetizovat jej do jazyka cílového, a do jaké míry modelujeme chování lidského překladatele. Od chvíle, kdy Chomsky před téměř padesáti lety vyhlásil svůj program jako snahu o integraci lingvistiky s kognitivní psychologií, se odpovědi různí...
S touto problematikou souvisí právě otázky vztahující se k již zmiňovanému článku. V tom se totiž tvrdí, že "do praxe totiž míří nová generace programů, která se nezatěžuje větným rozborem, ale sází na hrubou sílu a velké slovníky vzorových textů". To je tvrzení přinejmenším nepřesné a zároveň i nechtěně zavádějící. Z textu se bohužel nedozvíme podrobněji, jak celý proces funguje, zjistíme jen, že "princip je jednoduchý: program na začátku o cizím jazyce „neví“ nic. Ale dostane k dispozici velké množství textů ve zdrojovém a v cílovém jazyce a pak si v nich sám najde pravidla. Například v případě překladu z arabštiny do angličtiny stroj opakovaně srovnává řetězce textu v arabštině s jejich anglickými protějšky a postupně vytvoří hrubý překlad. Následně text vyladí s využitím vzorů „odkoukaných“ z učebních anglických textů, čímž napodobí slovosled přirozeného jazyka. Není potřeba programovat algoritmy simulující gramatická pravidla, což je velmi náročné, málo efektivní a hlavně - musí se vytvářet pro každý jazyk zvlášť". To je ale nejen těžko pochopitelné, ale zamlčuje to jisté předpoklady.
Tvrzení, že "program na začátku o cizím jazyce „neví“ nic" by bylo nutné asi poopravit v tom smyslu, že program neobsahuje sice žádnou konkrétní implementaci gramatických pravidel daných jazyků, ale nejspíš procedury, jak taková pravidla vytvářet (ve smyslu "nacházet" v textu data a na jejich základě je generovat). To znamená, že počítač není lockovská tabula rasa, ale obsahuje algoritmy pro tvorbu pravidel na základě statistických dat. Ty defacto modelují kognitivní bázi pro zpracovávání jistého typu informací. Vytváří statistické korelace na základě srovnání textů z paralelních korpusů. Vybaven těmito statistickými korelacemi (charakteristickými zřejmě v této fázi pro určitý omezený typ textů, ale potenciálně využitelný i mimo rámec jejich okruhu) poté přistupuje k neznámému textu ve zdrojovém jazyce a pokouší se vytvořit jeho zobrazení v jazyce cílovém. Jen takto dokážu rozumět tvrzení, že "například v případě překladu z arabštiny do angličtiny stroj opakovaně srovnává řetězce textu v arabštině s jejich anglickými protějšky a postupně vytvoří hrubý překlad". Program se tedy opírá o zákonitosti formulované v teorii informace a na jejich základě analyzuje zdrojový text a generuje text cílový. Poznámku o vylaďování slovosledu, které se v případě statisticky zpracovávaného překlad opravdu užívá, by asi bylo vhodné také upřesnit, protože slovosled není v mnoha jazycích záležitostí libovolnou, ale je součástí jazykových pravidel, tedy nikoliv pouze otázkou stylistickou. (Ani čeština není - na rozdíl od toho, co se obvykle tvrdí - v otázce slovosledu absolutně bez omezení: i zde má slovosled sémanticko-gramatickou distinktivní funkci.)
V čem má zmiňovaný článek naprostou pravdu, je tvrzení, že klasický algoritmizovaný překlad postavený na implementaci jazykové struktury ve formě pravidel (rule-based či transfer-based machine translation) je jednak mimořádně náročný, jednak je nutné zpracovávat jej pro každý jazyk zvlášť. Není přitom nutné zpracovávat převodní pravidla vždy pro dvojici jazyků, ale pouze ve vztahu k jazyku převodnímu, který by měl představovat univerzální reprezentaci daných vět. Nutné je ale dodat, že i odborníci věnující se tomuto typu strojového překladu uznávají, že v mnoha případech je ideální kombinovat tuto metodu právě s metodou statistickou.
Obrovská výhoda statistického strojového překladu je v jeho relativně univerzální použitelnosti, snazší přípravě, ale například i ve schopnosti poradit si s jevy známými z teorie komunikace, jako je přítomnost šumu apod. Zatímco detaily jsou už otázkou pro odborníky, je možné zamyslet se nad obecnou otázkou nechtěně položenou v úvodu komentovaného článku: je výraz hrubá síla vhodný pro charakteristiku takového typu překladu? Nejprve je třeba říct, že se jedná o termín běžně užívaný v informatice a má charakterizovat taková řešení, která se opírají o velké datové databáze, tj. ne o implementaci hotových pravidel. Je pravdou, že takový překlad je také možné chápat jako primárně formální nebo čistě syntaktický v širokém smyslu slova - hledá se korelace ve smyslu substituce elementu za element na základě jejich formy, případně kontextového okolí. Takový přístup nebuduje něco jako sémantickou bázi, pracuje s pravděpodobností výskytu apod. Je omezen stanoveným korpusem, ze kterého se program "učí". Potud je konotace výrazu hrubá síla nejspíš správná. Vzato ale ze druhé strany - významem slova je dle Wittgensteina, vlivného filosofa jazyka, způsob jeho užívání v jazykových hrách, tj. znát význam znamená náležitě užívat jazykové výrazy - adekvátně situaci. Evidence je čistě behaviorální - pokud je jazykový výraz "tam, kde má být", mluvčí jej použil správně - ve shodě s jeho významem. Počítačový program, který produkuje texty, jež jsou v tomto smyslu adekvátní, ovládá v jistém slova smyslu určité aspekty významu jazykových výrazů. A tu se nám může vynořit z hloubek jazyka otázka: nejsou statistické metody - úspěšně aplikované ve výzkumu překladu - při vysvětlování principů učení se jazyku (čili v jistém ohledu schopnosti smysluplné komunikace v určité skupině, de Saussurovy langage) vhodnějším východiskem než představa o vrozené univerzální gramatice. Nejsou experimenty s trénováním umělých neuronových sítí a jejich zatím skromné, ale přesto nadějné výsledky pobídkou k cestě tímto směrem? A není spojení "hrubá síla" právě proto tak symptomaticky dvojznačné?...
Mnozí si to nemyslí a uvádějí pro to pádné důvody. O tom ale až příště.
Na vlastním výzkumu možností strojového překladu se záhy začalo pracovat i v tehdejším Československu. Z lingvistů se na něm podílela především skupina organizovaná kolem Petra Sgalla, osobnosti, která je v české lingvistice téměř synonymem pro algebraickou jazykovědu. V průběhu téměř padesáti let dosáhl tento tým (J. Panevová, E. Hajičová, E. Buráňová, S. Machová atd. atd.) mnoha úspěchů a uznání nejen v kontextu domácím - kde vlastně ani nebylo možné hovořit o nějaké alternativě - ale i v zahraničí. Přes všechny obrovské naděje, které byly v počátcích strojové lingvistiky do tohoto oboru vkládány, a o to větší pády, jež po vystřízlivění z těchto představ následovaly, se podařilo výzkum na tomto poli u nás nejen zachovat, ale i rozvinout a vybudovat tak silnou tradici, která je nesena několika významnými pracovišti, jako jsou například Ústav teoretické a komputační lingvistiky, Ústav formální a aplikované lingvistiky nebo Ústav českého národního korpusu.
Přestože zájem o strojovou lingvistiku byl motivován především praktickými cíli, je tato oblast mimořádně zajímavá z hlediska teoretické jazykovědy. Pokus zpracovat systém jazyka formálně za pomoci matematicko-informatických metod položil před jazykovědce ohromnou výzvu. V duchu Chomského návrhů je možné říct, že přišla chvíle, kdy lingvisté museli při popisu jazyka explicitně vyjádřit mnohé z toho, co bylo předpokládáno jako samozřejmé, že museli jasně a schematicky formulovat základní strukturní vlastnosti jazyků a soubory pravidel, o něž se může následná produkce řeči opřít - to všechno samozřejmě ve smyslu modelů "černé skříňky" a s omezením na to, co Chomsky definoval jako jazykovou kompetenci. Později, v souvislosti s tzv. pragmatickým nebo také komunikačním obratem v jazykovědě, se pochopitelně začal zájem části lingvistů modelujících jazykovou kompetenci pomocí matematických nástrojů obracet i k problémům spjatým s jeho užíváním, což byl jeden z procesů, který pomáhal formovat mosty k transdisciplinárním zkoumáním v rámci kognitivní vědy.
Z obecného hlediska je důležité především to, že v pozadí těchto snah stojí samozřejmě implicitně úvaha, co přesně je těmito postupy modelováno a jaké nároky, případně předpoklady adekvátnosti na tyto modely klást. Můžeme si například položit otázku, do jaké míry pouze vytváříme algoritmická schémata, která na základě požadavku co největší efektivity a mohutnosti dokáží analyzovat lineární vstup v podobě jazykového kódu a pomocí implementovaných "rozhodovacích" procedur je desambiguovat, vytvořit významový "zápis" v jazyce sloužícím jako terra comparationis a syntetizovat jej do jazyka cílového, a do jaké míry modelujeme chování lidského překladatele. Od chvíle, kdy Chomsky před téměř padesáti lety vyhlásil svůj program jako snahu o integraci lingvistiky s kognitivní psychologií, se odpovědi různí...
S touto problematikou souvisí právě otázky vztahující se k již zmiňovanému článku. V tom se totiž tvrdí, že "do praxe totiž míří nová generace programů, která se nezatěžuje větným rozborem, ale sází na hrubou sílu a velké slovníky vzorových textů". To je tvrzení přinejmenším nepřesné a zároveň i nechtěně zavádějící. Z textu se bohužel nedozvíme podrobněji, jak celý proces funguje, zjistíme jen, že "princip je jednoduchý: program na začátku o cizím jazyce „neví“ nic. Ale dostane k dispozici velké množství textů ve zdrojovém a v cílovém jazyce a pak si v nich sám najde pravidla. Například v případě překladu z arabštiny do angličtiny stroj opakovaně srovnává řetězce textu v arabštině s jejich anglickými protějšky a postupně vytvoří hrubý překlad. Následně text vyladí s využitím vzorů „odkoukaných“ z učebních anglických textů, čímž napodobí slovosled přirozeného jazyka. Není potřeba programovat algoritmy simulující gramatická pravidla, což je velmi náročné, málo efektivní a hlavně - musí se vytvářet pro každý jazyk zvlášť". To je ale nejen těžko pochopitelné, ale zamlčuje to jisté předpoklady.
Tvrzení, že "program na začátku o cizím jazyce „neví“ nic" by bylo nutné asi poopravit v tom smyslu, že program neobsahuje sice žádnou konkrétní implementaci gramatických pravidel daných jazyků, ale nejspíš procedury, jak taková pravidla vytvářet (ve smyslu "nacházet" v textu data a na jejich základě je generovat). To znamená, že počítač není lockovská tabula rasa, ale obsahuje algoritmy pro tvorbu pravidel na základě statistických dat. Ty defacto modelují kognitivní bázi pro zpracovávání jistého typu informací. Vytváří statistické korelace na základě srovnání textů z paralelních korpusů. Vybaven těmito statistickými korelacemi (charakteristickými zřejmě v této fázi pro určitý omezený typ textů, ale potenciálně využitelný i mimo rámec jejich okruhu) poté přistupuje k neznámému textu ve zdrojovém jazyce a pokouší se vytvořit jeho zobrazení v jazyce cílovém. Jen takto dokážu rozumět tvrzení, že "například v případě překladu z arabštiny do angličtiny stroj opakovaně srovnává řetězce textu v arabštině s jejich anglickými protějšky a postupně vytvoří hrubý překlad". Program se tedy opírá o zákonitosti formulované v teorii informace a na jejich základě analyzuje zdrojový text a generuje text cílový. Poznámku o vylaďování slovosledu, které se v případě statisticky zpracovávaného překlad opravdu užívá, by asi bylo vhodné také upřesnit, protože slovosled není v mnoha jazycích záležitostí libovolnou, ale je součástí jazykových pravidel, tedy nikoliv pouze otázkou stylistickou. (Ani čeština není - na rozdíl od toho, co se obvykle tvrdí - v otázce slovosledu absolutně bez omezení: i zde má slovosled sémanticko-gramatickou distinktivní funkci.)
V čem má zmiňovaný článek naprostou pravdu, je tvrzení, že klasický algoritmizovaný překlad postavený na implementaci jazykové struktury ve formě pravidel (rule-based či transfer-based machine translation) je jednak mimořádně náročný, jednak je nutné zpracovávat jej pro každý jazyk zvlášť. Není přitom nutné zpracovávat převodní pravidla vždy pro dvojici jazyků, ale pouze ve vztahu k jazyku převodnímu, který by měl představovat univerzální reprezentaci daných vět. Nutné je ale dodat, že i odborníci věnující se tomuto typu strojového překladu uznávají, že v mnoha případech je ideální kombinovat tuto metodu právě s metodou statistickou.
Obrovská výhoda statistického strojového překladu je v jeho relativně univerzální použitelnosti, snazší přípravě, ale například i ve schopnosti poradit si s jevy známými z teorie komunikace, jako je přítomnost šumu apod. Zatímco detaily jsou už otázkou pro odborníky, je možné zamyslet se nad obecnou otázkou nechtěně položenou v úvodu komentovaného článku: je výraz hrubá síla vhodný pro charakteristiku takového typu překladu? Nejprve je třeba říct, že se jedná o termín běžně užívaný v informatice a má charakterizovat taková řešení, která se opírají o velké datové databáze, tj. ne o implementaci hotových pravidel. Je pravdou, že takový překlad je také možné chápat jako primárně formální nebo čistě syntaktický v širokém smyslu slova - hledá se korelace ve smyslu substituce elementu za element na základě jejich formy, případně kontextového okolí. Takový přístup nebuduje něco jako sémantickou bázi, pracuje s pravděpodobností výskytu apod. Je omezen stanoveným korpusem, ze kterého se program "učí". Potud je konotace výrazu hrubá síla nejspíš správná. Vzato ale ze druhé strany - významem slova je dle Wittgensteina, vlivného filosofa jazyka, způsob jeho užívání v jazykových hrách, tj. znát význam znamená náležitě užívat jazykové výrazy - adekvátně situaci. Evidence je čistě behaviorální - pokud je jazykový výraz "tam, kde má být", mluvčí jej použil správně - ve shodě s jeho významem. Počítačový program, který produkuje texty, jež jsou v tomto smyslu adekvátní, ovládá v jistém slova smyslu určité aspekty významu jazykových výrazů. A tu se nám může vynořit z hloubek jazyka otázka: nejsou statistické metody - úspěšně aplikované ve výzkumu překladu - při vysvětlování principů učení se jazyku (čili v jistém ohledu schopnosti smysluplné komunikace v určité skupině, de Saussurovy langage) vhodnějším východiskem než představa o vrozené univerzální gramatice. Nejsou experimenty s trénováním umělých neuronových sítí a jejich zatím skromné, ale přesto nadějné výsledky pobídkou k cestě tímto směrem? A není spojení "hrubá síla" právě proto tak symptomaticky dvojznačné?...
Mnozí si to nemyslí a uvádějí pro to pádné důvody. O tom ale až příště.
neděle, října 29, 2006
Z věd o jazyce VIII: O filosofických kořenech lingvistiky
Filosofie je důležitá. Záleží na ní víc, než si mnozí lidé uvědomují, protože filosofické myšlenky, které se vyvinuly během staletí, vstupují do naší kultury v podobě světového názoru a ovlivňují nás tisíci různými způsoby. Na filosofii záleží také v akademickém světě, protože pojmové rámce, na nichž jsou založeny celé akademické disciplíny, mají obvykle své kořeny ve filosofii. Tyto kořeny jsou tak hluboké, že si je obvykle nikdo neuvědomuje. Zcela jistě to platí v mé disciplíně, lingvistice, ve které jsou klasická teorie kategorií a s ní spojené filosofické předpoklady natolik zažité, že se alternativní teorie zdají nemyslitelné. Jedním z mých cílů je ukázat, že klasická teorie kategorií není pro zkoumání přirozeného jazyka ani dalších aspektů myšlení dostačující a že potřebujeme nové filosofické předpoklady, abychom mohli vysvětlit jazykové jevy a další aspekty našeho kogntivního systému.
[G. Lakoff, Ženy, oheň a nebezpečné věci ]
středa, srpna 09, 2006
Z věd o jazyce VII: Neurolingvistika - mozková centra I
K základním neurolingvistickým problémům patří otázky týkající se možnosti mozkové lokalizace řečových předpokladů v užším slova smyslu, tj. snaha o vymezení oblastí neurálních korelátů jazyka - hledání tzv. řečových center. Přestože je už dnes jasné, že řečová produkce je složitý proces, na jehož průběhu se podílí mnoho oblastí lidského mozku, za hlavní mozková "centra řeči" byly díky tradici dlouho považovány dvě oblasti, tzv. Brocova a Wernickova area. Původní představa o jejich funkční samostatnosti a "dělbě úkolů" v rámci jednotlivých jazykových dovedností je už víceméně opuštěna, přesto - jak ukazují např. výzkumy afázií - mají obě oblasti přeci jen jisté specifické charakteristiky týkající se produkce a percepce řeči. Protože ale přetrvávají nejasnosti v přesném umístění těchto oblastí, operuje se při lokalizaci jazykových schopností s jemnějším a prostorově rozsáhlejším vymezením. (O tom, že i samotná hypotéza předpokládající lokalizovatelnost - nejen jazykových - schopností je problematická, příště).
S těmito otázkami úzce souvisí nedávno publikované výsledky výzkumu vědců z National Institute of Deafness and Other Communication Disorders, National Institute of Mental Health aj. V časopise Nature Neuroscience tým vedený Allenem Braunem poukazuje na určitou podobnost mezi neurální lokalizací řečových schopností u lidí a makaků.
Zjednodušeně řečeno, cílem bylo odpovědět na otázku, jestli morfologická podobnost mozků obou živočišných druhů vykazuje v otázkách komunikace i podobnosti funkční. Pomocí vyšetření formou pozitronové emisní tomografie (PET) bylo zjištěno, že makakové aktivují při komunikaci v rámci druhu podobné mozkové oblasti jako lidé. Stejně tak bylo zjištěno, že v případě tzv. pseudozvuků (tj. zvuků, které znějí podobně jako zvuky používané makaky ke komunikaci; ekvivalent lidských pseudoslov) dochází podobně jako u lidí pouze k aktivaci té oblasti, která zpracovává zvuky jako takové, nikoliv zvuky, které jsou součástí daného komunikačního systému.
Uvedená zjištění představují cenný příspěvek do debaty o evoluci člověka a také o evoluci jeho jazykových schopností. Právě v této oblasti panuje stále mnoho nejasností a teoretických rozporů. Jednou z otázek je, jestli lidský jazyk představuje komunikační systém principiálně a zásadně odlišný od komunikačních systémů ostatních živočišných druhů, nebo jestli leží pouze na škále od těch velmi jednoduchých až po velmi komplikované, ale principiálně odlišný není. Související otázkou pak je, jak se lidský jazyk vyvinul, jakým způsobem došlo k tomu, že člověk začal disponovat takovou komunikační schopností, která pro něj představovala zřejmou evoluční výhodu. Právě podobná srovnání umožňují zajímavý vhled do některých mechanismů lidské řeči.
U makaků je za homologickou oblast lidské Brocovy arey považována oblast F5, která obsahuje tzv. zrcadlové neurony. Ty reprezentují ztotožnění pozorované aktivity se stejnou, ale vnitřně generovanou aktivitou. Podle výzkumů Giacoma Rizzolattiho je oblast F5 jakýmsi "prekurzorom Brocovej oblasti a vývoj ľudskej jazykovej oblsti je dosledkom existencie neurónového systému na stotožňovanie akcií vykonávaných inými s vlastnými akciami" (Beňušková). Bylo totiž zjištěno, že Brocova area se aktivuje i během pohybu rukou, představování si jejich pohybu a během mentální rotace zahrnující ruce. Zároveň je třeba si uvědomit, že Brocova area je někdy považována za premotorickou oblast pro svaly produkující řeč a je aktivní při syntaktických operacích. Jedním z vyvozených závěrů tak může být nejenom gestický původ lidského jazyka, ale i pojetí myšlení jako "kontemplácie akcií v nejakom priestore" (Beňušková).
Podobně zajímavou zprávou je informace o objevení jazykového genu, publikovaná odborníky z Planckova ústavu evoluční antropologie. Mělo by jít o gen FOXP2. Důkazem, že jde o gen nějak související s lidskou jazykovou schopností, má být jeho mutace oproti stejnému genu u ostatních savců a to, že jedinci s jeho poškozením mají artikulační problémy a problémy spojené s gramatikou. Že nejde pouze o motorickou poruchu mají dokazovat vážné problémy právě s gramatickou kompetencí postižených mluvčích. Tyto výzkumy tedy nejen uvádějí do spojitosti motoriku mluvidel a syntaktickou kompetenci, ale zároveň v jistém smyslu podporují jednu ze silných obecně lingvistických hypotéz: tu o genetické predispozici pro fungování komunikačního systému v takové komplexitě, jakou vykazuje lidský jazyk.
Domnívám se, že to ještě nijak NUTNĚ nepodporuje teorii, že je vrozena univerzální gramatika jako taková. Podle mě je totiž možné tuto mutaci interpretovat jako ke svému konečnému určení tzv. agnostickou. Může sice poskytovat výhodné podmínky pro fungování jazyka, ale geneticky jej nekóduje. Argumenty proti genetické predispozici jazyka totiž tvrdí, že nebyl pravděpodobně dostatek času na to, aby se u člověka zakódovala genetická báze pro jazykové struktury, jako je gramatika (viz např. Altmann). Argumentů podporující vrozenost jazyka (ve formě univerzální gramatiky), je samozřejmě také shromážděno celé množství. O tom ale třeba někdy příště.
Zdroje: Gil-da-Costa, R., Martin, A., Lopes, M., Monica Munoz , M., Fritz, Wise, S.P., Braun, A.R.: Species-specific calls activate homologues of Broca’s and Wernicke’s areas in the macaque. In: Nature Neuroscience vol 9, No 8 (abstract); Beňušková, L.: Kde se jazyk stretáva s vedomím. In: Jazyk a kognicia. Bratislava 2005; Giacomo Rizzolatti and Michael A. Arbib: Language within our grasp. In: Trends in Neurosciences, Volume 21, Issue 5, 1 May 1998, Pages 188-194 (abstract); Altmann, G.: Výstup na babylonskou věž. Praha 2005, Mihulka, S.: Řečová centra v mozku makaků.
(http://www.rozhlas.cz/priroda/portal/_zprava/265350; 10. 8. 2006)

S těmito otázkami úzce souvisí nedávno publikované výsledky výzkumu vědců z National Institute of Deafness and Other Communication Disorders, National Institute of Mental Health aj. V časopise Nature Neuroscience tým vedený Allenem Braunem poukazuje na určitou podobnost mezi neurální lokalizací řečových schopností u lidí a makaků.
Zjednodušeně řečeno, cílem bylo odpovědět na otázku, jestli morfologická podobnost mozků obou živočišných druhů vykazuje v otázkách komunikace i podobnosti funkční. Pomocí vyšetření formou pozitronové emisní tomografie (PET) bylo zjištěno, že makakové aktivují při komunikaci v rámci druhu podobné mozkové oblasti jako lidé. Stejně tak bylo zjištěno, že v případě tzv. pseudozvuků (tj. zvuků, které znějí podobně jako zvuky používané makaky ke komunikaci; ekvivalent lidských pseudoslov) dochází podobně jako u lidí pouze k aktivaci té oblasti, která zpracovává zvuky jako takové, nikoliv zvuky, které jsou součástí daného komunikačního systému.
Uvedená zjištění představují cenný příspěvek do debaty o evoluci člověka a také o evoluci jeho jazykových schopností. Právě v této oblasti panuje stále mnoho nejasností a teoretických rozporů. Jednou z otázek je, jestli lidský jazyk představuje komunikační systém principiálně a zásadně odlišný od komunikačních systémů ostatních živočišných druhů, nebo jestli leží pouze na škále od těch velmi jednoduchých až po velmi komplikované, ale principiálně odlišný není. Související otázkou pak je, jak se lidský jazyk vyvinul, jakým způsobem došlo k tomu, že člověk začal disponovat takovou komunikační schopností, která pro něj představovala zřejmou evoluční výhodu. Právě podobná srovnání umožňují zajímavý vhled do některých mechanismů lidské řeči.
U makaků je za homologickou oblast lidské Brocovy arey považována oblast F5, která obsahuje tzv. zrcadlové neurony. Ty reprezentují ztotožnění pozorované aktivity se stejnou, ale vnitřně generovanou aktivitou. Podle výzkumů Giacoma Rizzolattiho je oblast F5 jakýmsi "prekurzorom Brocovej oblasti a vývoj ľudskej jazykovej oblsti je dosledkom existencie neurónového systému na stotožňovanie akcií vykonávaných inými s vlastnými akciami" (Beňušková). Bylo totiž zjištěno, že Brocova area se aktivuje i během pohybu rukou, představování si jejich pohybu a během mentální rotace zahrnující ruce. Zároveň je třeba si uvědomit, že Brocova area je někdy považována za premotorickou oblast pro svaly produkující řeč a je aktivní při syntaktických operacích. Jedním z vyvozených závěrů tak může být nejenom gestický původ lidského jazyka, ale i pojetí myšlení jako "kontemplácie akcií v nejakom priestore" (Beňušková).
Podobně zajímavou zprávou je informace o objevení jazykového genu, publikovaná odborníky z Planckova ústavu evoluční antropologie. Mělo by jít o gen FOXP2. Důkazem, že jde o gen nějak související s lidskou jazykovou schopností, má být jeho mutace oproti stejnému genu u ostatních savců a to, že jedinci s jeho poškozením mají artikulační problémy a problémy spojené s gramatikou. Že nejde pouze o motorickou poruchu mají dokazovat vážné problémy právě s gramatickou kompetencí postižených mluvčích. Tyto výzkumy tedy nejen uvádějí do spojitosti motoriku mluvidel a syntaktickou kompetenci, ale zároveň v jistém smyslu podporují jednu ze silných obecně lingvistických hypotéz: tu o genetické predispozici pro fungování komunikačního systému v takové komplexitě, jakou vykazuje lidský jazyk.
Domnívám se, že to ještě nijak NUTNĚ nepodporuje teorii, že je vrozena univerzální gramatika jako taková. Podle mě je totiž možné tuto mutaci interpretovat jako ke svému konečnému určení tzv. agnostickou. Může sice poskytovat výhodné podmínky pro fungování jazyka, ale geneticky jej nekóduje. Argumenty proti genetické predispozici jazyka totiž tvrdí, že nebyl pravděpodobně dostatek času na to, aby se u člověka zakódovala genetická báze pro jazykové struktury, jako je gramatika (viz např. Altmann). Argumentů podporující vrozenost jazyka (ve formě univerzální gramatiky), je samozřejmě také shromážděno celé množství. O tom ale třeba někdy příště.
Zdroje: Gil-da-Costa, R., Martin, A., Lopes, M., Monica Munoz , M., Fritz, Wise, S.P., Braun, A.R.: Species-specific calls activate homologues of Broca’s and Wernicke’s areas in the macaque. In: Nature Neuroscience vol 9, No 8 (abstract); Beňušková, L.: Kde se jazyk stretáva s vedomím. In: Jazyk a kognicia. Bratislava 2005; Giacomo Rizzolatti and Michael A. Arbib: Language within our grasp. In: Trends in Neurosciences, Volume 21, Issue 5, 1 May 1998, Pages 188-194 (abstract); Altmann, G.: Výstup na babylonskou věž. Praha 2005, Mihulka, S.: Řečová centra v mozku makaků.
(http://www.rozhlas.cz/priroda/portal/_zprava/265350; 10. 8. 2006)
Přihlásit se k odběru:
Příspěvky (Atom)